La conteneurisation n'est plus un avantage concurrentiel, c'est la base. La plupart des équipes d'ingénierie utilisent Docker. Un nombre surprenant d'entre elles ont Kubernetes. Bien moins nombreuses sont celles dont l'infrastructure soutient réellement la vitesse de livraison, l'efficacité des coûts et la croissance du produit – et c'est souvent à cet endroit que les choses se cassent.
Chez Softvery Solutions, nous avons cessé de traiter Docker et Kubernetes comme une simple liste de contrôle technique. Ce sont des compromis qui doivent correspondre à l'état réel d'un produit – pas à celui dont une équipe rêve.
La vraie question n'est pas « Docker ou pas », mais « quelle part de complexité votre équipe peut-elle absorber en ce moment ? »
Les outils ont mûri. L'écosystème est riche. Ce qui n'a pas changé, c'est la tension fondamentale : les plateformes d'orchestration assez puissantes pour fonctionner à grande échelle sont aussi assez complexes pour vous ralentir si elles sont introduites trop tôt ou configurées sans discipline.
Nous voyons régulièrement ce schéma. Une équipe fondatrice de trois ingénieurs met en place Kubernetes parce que cela lui semble le bon choix à long terme. Dix-huit mois plus tard, elle consacre une part disproportionnée de son temps d'ingénierie à gérer l'infrastructure, à déboguer des problèmes de planification et à ajuster des limites de ressources – au lieu de construire le produit. La plateforme ne l'a pas trahie. C'est le calendrier qui l'a fait.
Cela compte surtout à deux points d'inflexion : quand une équipe, avant le product-market fit, cherche à aller vite, et quand une équipe a trouvé sa traction et doit passer à l'échelle sans épuiser l'organisation d'ingénierie.
Docker : les problèmes qui suivent encore les équipes jusqu'en production
La proposition de valeur centrale de Docker – cohérence des environnements, builds reproductibles, artefacts portables – est bien comprise. Ce qui l'est moins, c'est la rapidité avec laquelle une configuration Docker non disciplinée accumule de la dette technique.
La prolifération et l'embonpoint des images restent un problème persistant. Les équipes construisent des images qui contiennent des chaînes d'outils de build, des dépendances de développement, des caches locaux et des fichiers source qui n'ont rien à faire dans un conteneur de production. Il en résulte des images plus lourdes de plusieurs centaines de mégaoctets que nécessaire, des pipelines CI plus lents, des coûts de registre plus élevés et des démarrages à froid plus longs. Les builds multi-étapes sont la solution standard et fonctionnent bien – mais nous voyons encore des environnements de production où ils n'ont pas été appliqués.
La sécurité autour des images de base est plus urgente qu'il y a deux ans. Dans un monde où les charges de travail IA s'exécutent dans des environnements conteneurisés proches de données sensibles et de poids de modèles, une image de base vulnérable n'est pas qu'un problème d'exploitation – c'est un problème de conformité et de responsabilité. L'analyse automatisée avec des outils comme Trivy ou Docker Scout doit faire partie du pipeline, et non être une étape manuelle.
Le risque lié à la chaîne d'approvisionnement est devenu une vraie préoccupation. Des tags non épinglés signifient qu'un rebuild peut récupérer en silence une image différente de celle qui a été testée. Dans les secteurs réglementés – fintech, healthtech, tout produit touchant à des données personnelles – ce sont des constats d'audit qui n'attendent qu'à se produire. L'approche que nous recommandons : utiliser des images de base minimales, épingler les digests plutôt que les tags, analyser à chaque build et traiter le registre de conteneurs comme faisant partie de votre périmètre de sécurité.
Si vous cherchez encore à déterminer si le périmètre de votre MVP est le bon, il est peut-être trop tôt pour introduire une complexité d'orchestration inutile. En revanche, si vous savez déjà que le produit devra passer à l'échelle, alors la bonne base compte énormément.
Kubernetes : le coût de la complexité est réel et souvent sous-estimé
Kubernetes est réellement excellent dans ce qu'il fait. Pour les équipes qui exploitent des systèmes distribués à une échelle significative, difficile de lui trouver des défauts. Le problème, c'est qu'il impose une taxe cognitive et opérationnelle qui se cumule avec le temps.
Pods, deployments, replica sets, services, ingress controllers, config maps, secrets, namespaces, RBAC, network policies, persistent volume claims, storage classes – ce n'est pas une petite surface à comprendre et à maintenir. Chaque nouvelle version de Kubernetes apporte des dépréciations, des changements d'API et des cycles de mise à niveau dont quelqu'un dans l'équipe doit être responsable.
Les questions à se poser avant de l'adopter : Avez-vous une variabilité de trafic qui profite réellement de l'autoscaling dynamique, ou optimisez-vous pour un problème que vous n'avez pas encore ? Votre équipe a-t-elle la maturité opérationnelle pour déboguer des échecs de planification et des conflits de ressources sous pression ? La couche Kubernetes apporte-t-elle de la fiabilité, ou ajoute-t-elle une nouvelle catégorie de modes de défaillance ?
Pour les produits en phase initiale, une plateforme managée – Railway, Render, Fly.io – apporte souvent 80 % du bénéfice opérationnel pour 20 % de la complexité. L'argument en faveur de Kubernetes se renforce lorsque vous avez de véritables architectures multi-services, des besoins complexes d'autoscaling ou des exigences strictes de contrôle de l'infrastructure.
Là où la complexité de Kubernetes est réellement rentable
Les charges de travail IA et GPU sont aujourd'hui l'un des arguments les plus solides en faveur de Kubernetes en 2026. Exploiter efficacement des nœuds équipés de GPU, planifier des tâches d'inférence aux côtés d'autres services, absorber des pics de demande de calcul – Kubernetes, avec ses pools de nœuds et ses taints/tolerations, offre aux équipes un contrôle que les plateformes managées ne proposent pas. Si vous faites tourner des modèles en production, l'infrastructure compte énormément.
La parité entre environnements est un vrai gain, facile à sous-estimer. Promouvoir exactement le même artefact du staging à la production, avec une configuration propre à chaque environnement injectée à l'exécution, élimine une catégorie de bugs autrement difficiles à diagnostiquer.
L'optimisation des coûts à grande échelle est sous-estimée. Cluster Autoscaler et KEDA permettent aux équipes d'ajuster les dépenses de calcul à la demande réelle plutôt que de provisionner en permanence pour le pic. Cela ne fonctionne toutefois que si les requêtes et limites de ressources sont correctement définies et que l'autoscaling est réglé sur des données de performance réelles – pas sur les valeurs par défaut.
La complexité réseau est l'endroit où les équipes sous-estiment le plus souvent le coût. Quand des services doivent se découvrir de façon fiable entre namespaces et environnements, un ingress ou une configuration DNS mal réglés ne créent pas seulement de la latence – ils provoquent des pannes intermittentes pénibles à déboguer sous pression. Les service meshes comme Istio résolvent de vrais problèmes à grande échelle, mais ajoutent aussi une couche qui demande un responsable opérationnel. Introduisez cette complexité quand vous avez le problème, pas par anticipation.
Le problème d'observabilité dont on ne parle pas assez
Kubernetes n'apporte pas l'observabilité. Il apporte l'infrastructure pour la construire – une différence notable. Nous avons vu des clusters de production tourner pendant des mois sans alerting pertinent, les équipes ne découvrant les problèmes que lorsque les utilisateurs les signalaient. C'est un risque produit déguisé en lacune d'infrastructure.
L'observabilité en 2026 signifie de plus en plus bien plus que des métriques et des logs. Le traçage distribué (OpenTelemetry est devenu le standard de fait), l'attribution des coûts par service et l'alerting fondé sur les SLO sont des éléments que les équipes matures intègrent tôt dans leur stack. Mais la surcharge de supervision est tout aussi réelle : les équipes qui instrumentent tout constatent souvent que le volume d'alertes devient du bruit, suivi de la fatigue des astreintes. L'objectif n'est pas de collecter toutes les données – c'est d'avoir un signal clair quand quelque chose d'important ne va pas.
Quand Kubernetes est superflu – et ce que coûte son usage malgré tout
Kubernetes est superflu pour une large part des produits qui l'utilisent. Si vous avez une poignée de services, un trafic prévisible et une équipe qui doit aller vite, la charge opérationnelle est une taxe directe sur la vélocité. Le vrai coût, c'est le poids cognitif qui alourdit chaque décision d'infrastructure. C'est le niveau de recrutement qui monte quand il faut des personnes capables d'exploiter la plateforme. C'est la complexité des incidents lorsque quelque chose tourne mal dans un système distribué comportant de nombreuses pièces mobiles.
Kubernetes après le product-market fit est un point d'inflexion fréquent. Le produit a de la traction, le trafic augmente et l'équipe commence à sentir les limites de la configuration de déploiement d'origine. C'est souvent le bon moment pour investir dans l'orchestration de conteneurs – mais l'investissement doit être délibéré, cadré et accompagné de la structure d'équipe capable de le soutenir.
Les décisions d'infrastructure sont des décisions produit
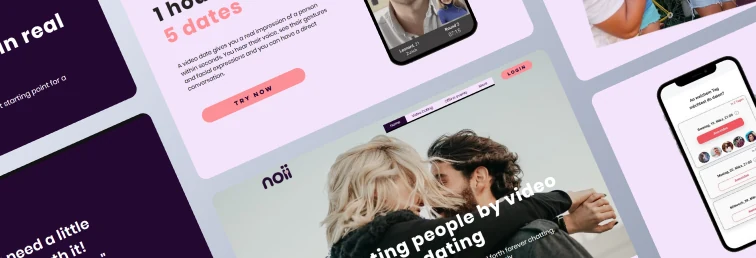
Le travail que nous avons réalisé pour Noii, une plateforme de speed dating, en est un bon exemple. L'équipe n'avait pas de plan de migration de base de données, des contrôles d'accès incohérents et des processus de déploiement qui créaient un risque à chaque release. Nous avons introduit Terraform pour la gestion du VPC, migré vers AWS RDS, configuré IAM correctement et mis en place un pipeline CI/CD. Le résultat n'était pas seulement une configuration plus propre – c'était une base qui permettait à l'équipe produit d'avancer plus vite et avec plus de confiance.
Ce type d'intervention fonctionne mieux lorsqu'il est aligné sur ce dont le produit a réellement besoin, et non sur ce que l'infrastructure pourrait idéalement être. Le même principe s'applique, que l'équipe ajoute une première couche DevOps ou repense une architecture qui commence à freiner la livraison.
Les équipes qui y parviennent ont tendance à avoir un point commun : elles traitent les décisions d'infrastructure avec la même rigueur que les décisions produit. Non pas « quelle est la meilleure technologie ? » mais « que nous coûte son exploitation, et ce coût a-t-il du sens à notre stade actuel ? » Cette façon de raisonner mène généralement à de meilleurs résultats que l'alternative.