L'un de nos projets en cours est une plateforme étudiante pour des programmes d'études à l'étranger. Le client avait déjà fait un sérieux travail de fond : un modèle ML entraîné, un jeu de données propre, un chatbot qui répondait correctement aux questions des utilisateurs. Selon la plupart des critères, la base technique était solide.
Mais le produit ne se comportait pas comme une conversation. Un utilisateur écrivait quelque chose – « Je veux étudier à l'étranger, j'ai un budget d'environ 5 000 à 10 000 € » – et le bot répondait correctement, puis attendait. Aucune relance. Aucune clarification. Aucune proposition d'aide pour l'étape suivante. Chaque échange repartait de zéro. Le modèle répondait, mais il n'écoutait pas.
C'est le problème que l'on nous a demandé de résoudre. Et la décision d'architecture au cœur de celui-ci était de savoir s'il fallait utiliser MCP.
Ce qu'est MCP et pourquoi il compte ici
MCP – Model Context Protocol – est un standard de communication qui permet à un modèle d'IA de dialoguer directement avec des systèmes backend : bases de données, API, logique applicative. Il a été introduit par Anthropic fin 2024 et est devenu depuis l'une des décisions d'infrastructure les plus importantes pour les équipes qui développent des produits reposant sur l'IA.
L'alternative – que la plupart des premières intégrations d'IA utilisent – passe par des couches intermédiaires : le modèle envoie une requête, une couche d'API interroge la base de données, le résultat remonte par les mêmes couches, et le modèle le reçoit enfin. Chaque couche ajoute de la latence. Chaque couche est un point de défaillance potentiel. Chaque couche limite le contexte auquel le modèle peut accéder en temps réel.
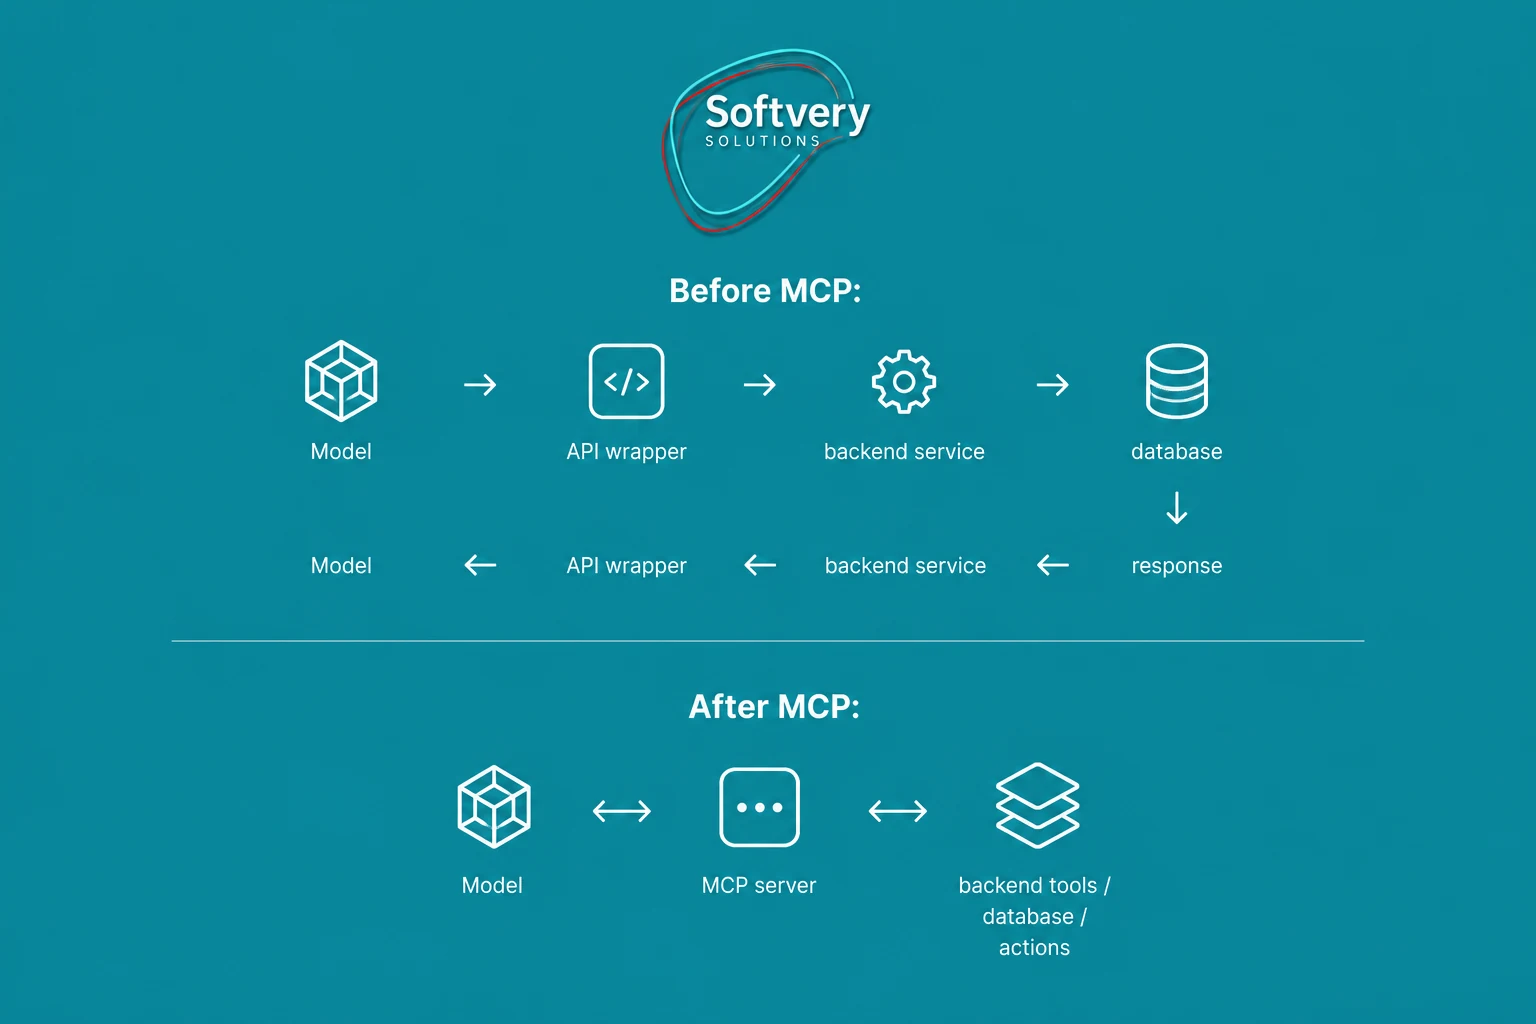
MCP supprime ces couches intermédiaires. Le modèle se connecte directement. Le résultat, ce sont des réponses plus rapides – mais surtout, cela change ce que la conversation peut accomplir, car le modèle a désormais un accès en direct aux données dont il a besoin pour être réellement utile, et pas seulement techniquement exact.
La différence compte surtout dans les produits où la qualité de la conversation est le produit. Un chatbot qui répond avec exactitude mais ne peut ni conserver le contexte, ni poser de questions de suivi, ni agir à partir de ce qu'il sait n'est pas un produit conversationnel. C'est une interface de recherche dans un emballage plus sympathique.
Ce dont le client avait besoin – et ce que cela impliquait techniquement
L'objectif du client était précis : un bot qui se comporte comme le ferait un conseiller humain compétent. Si un utilisateur mentionne son budget, le bot s'en souvient. Si l'utilisateur pose une question sur les conditions de visa en plein milieu d'une conversation sur des options de cours, le bot y répond sans perdre le fil. Si le bot peut aider à franchir une étape – présélectionner des cours, réserver un rappel, envoyer une comparaison – il le propose.
Un tel comportement exige trois éléments qui fonctionnent ensemble : le modèle doit conserver le contexte tout au long d'une session, il doit accéder aux données produit en temps réel, et il doit pouvoir déclencher des actions dans le backend.
Nous en avons discuté avec Anastasiya, notre PM sur le projet, pour comprendre d'où venait réellement la décision d'architecture – et pourquoi le problème ne pouvait pas être résolu au niveau du modèle.
Anastasiya — PM
Le modèle lui-même n'était pas le problème. Le problème, c'était sa connexion avec tout le reste. Toutes les données – catalogue de cours, tarifs, disponibilités – se trouvaient dans la base de données, mais le modèle ne pouvait pas y accéder en temps réel. Il répondait à partir de ce sur quoi il avait été entraîné, et non de ce qui était réellement vrai à l'instant. Et il ne pouvait effectuer aucune action. Il pouvait vous dire qu'un cours existait, mais pas vous aider à agir. Le POC que nous avons construit a montré qu'un serveur MCP pouvait combler ce manque immédiatement : connecté directement au backend, le modèle pouvait récupérer des données en direct en pleine conversation, conserver le contexte de session et déclencher des actions backend sans la latence de couches intermédiaires.
Qui devrait piloter ce type d'intégration – et pourquoi
Cette question, nous l'entendons sous diverses formes sur presque tous les projets d'intégration d'IA : faut-il un spécialiste IA/ML pour la mettre en œuvre ?
Pour une intégration MCP, la réponse est non – et comprendre pourquoi est important pour cadrer et budgéter ce travail.
MCP n'est pas du développement de modèle. Vous n'entraînez, n'affinez ni ne modifiez le modèle lui-même. Vous construisez la couche de connexion entre un modèle existant et vos systèmes existants. Le plus difficile n'est pas de connecter le modèle – c'est de définir précisément ce à quoi le modèle peut accéder de façon sûre et stable dans un environnement de production réel. Cela demande quelqu'un qui connaît votre backend en profondeur, pas quelqu'un qui connaît les modèles en profondeur.
Anastasiya — PM
Vlad est notre développeur backend sur ce projet. Vlad travaille dans cette base de code depuis le début. Il connaît le backend, la logique produit, il comprend comment les données sont structurées et où se trouvent les cas limites. Ce contexte vaut ici davantage que des compétences spécifiques en IA. Quelqu'un venant de l'extérieur, même avec une solide expérience en ML, aurait besoin de plusieurs mois pour arriver là où il est déjà. L'intégration doit s'adapter précisément au système existant – et cette précision vient de la connaissance du produit, pas de celle du modèle.
Cela a une implication concrète pour les équipes qui prévoient un travail similaire : la bonne personne pour piloter une intégration MCP est probablement déjà dans votre équipe.
Les détails techniques qui comptent vraiment
Faire fonctionner l'intégration MCP n'est que le début, pas la fin. Ce qui détermine si elle tient en production se résume à quatre points qui ne sont pas assez discutés dans la plupart des articles sur le sujet.
Les limites des outils. Le modèle a besoin de limites clairement définies sur ce qu'il peut interroger et sur ce qu'il ne doit pas toucher. Toutes les tables de la base de données ne sont pas pertinentes pour une conversation avec un utilisateur – et certaines données ne devraient jamais être accessibles au niveau du modèle, en aucune circonstance. Définir ces limites en amont est une décision de sécurité et de produit, pas seulement technique.
La logique d'autorisations. Certaines actions, le modèle peut les réaliser de façon autonome : récupérer des données de cours, mémoriser le contexte de la session, générer une présélection. D'autres exigent une confirmation explicite de l'utilisateur avant d'être exécutées : réserver un rappel, envoyer un e-mail de comparaison, déclencher toute étape proche d'une transaction. La distinction entre actions automatiques et actions confirmées doit être conçue délibérément, et non laissée au hasard du comportement de l'intégration.
Le comportement de repli. Les connexions de données en direct échouent. La disponibilité des cours change entre le début et la fin d'une session. Les données tarifaires peuvent être incomplètes. Le modèle doit gérer ces cas avec élégance – reconnaître ce qu'il ne sait pas, proposer ce qu'il sait et ne jamais présenter des données périmées comme actuelles. La logique de repli est facile à négliger et coûteuse à corriger en production.
L'observabilité. Dans un produit classique, on journalise les erreurs. Dans un produit intégrant MCP, il faut journaliser bien davantage : les appels d'outils effectués par le modèle, la latence de chaque appel, les actions échouées, les données renvoyées par les requêtes backend, la façon dont le modèle a interprété l'intention de l'utilisateur et le moment où le comportement de repli s'est déclenché. Sans cela, le débogage en production relève de la devinette.
Les tests. Tester une intégration MCP, c'est tester bien plus que la qualité de la conversation. Il faut tester le comportement de l'intégration backend, les flux d'autorisations, la logique de confirmation des actions et les cas limites dans les données – indépendamment de la fluidité du dialogue. Une conversation peut sembler naturelle alors qu'une limite d'autorisations est défaillante en dessous.
Comment nous avons structuré les options de collaboration
Une partie de notre travail sur ce type de projet consiste à donner aux clients une image réaliste de leurs options – pas seulement techniques, mais aussi en matière de réalisation et de budget. Sur ce projet, nous avons présenté trois voies.
La première : notre équipe prend en charge toute l'intégration MCP. Une livraison propre, une responsabilité totale, le coût le plus élevé.
La deuxième : notre développeur backend travaille aux côtés de leur ingénieur interne – livraison partagée, transfert de connaissances intégré, coût réduit. L'ingénieur du client sort de la mission avec une expérience concrète de MCP sur son propre système. C'est l'option vers laquelle penche le client, et nous pensons que c'est le bon choix compte tenu de sa situation.
La troisième : nous conseillons pendant que leur équipe réalise l'implémentation. Le coût le plus bas, mais le risque le plus élevé si leur ingénieur n'a jamais travaillé avec MCP.
La deuxième option convient particulièrement aux intégrations comme celle-ci, où le client dispose d'une équipe technique capable et d'une feuille de route produit à long terme. L'intégration n'est pas un travail ponctuel – elle devra évoluer avec le produit. Intégrer dès le départ une compétence interne vaut bien un calendrier légèrement plus long.
Ce qui change quand c'est bien fait
La version de ce produit qui existe au terme d'une intégration MCP bien menée est fondamentalement différente de celle du départ – non pas parce que le modèle a changé, mais parce que le modèle peut désormais faire son travail.
Un utilisateur qui arrive avec un budget, un calendrier et une idée vague de ce qu'il veut peut avoir une vraie conversation. Le bot peut poser les bonnes questions de suivi, récupérer des données de cours exactes en temps réel, se souvenir de ce qui a été établi plus tôt dans la session et aider à avancer vers une décision.
L'écart entre « j'ai une question » et « j'ai une prochaine étape » se réduit nettement – et c'est dans cet écart que se joue la conversion, que la confiance de l'utilisateur se construit ou se perd, et que le produit se justifie ou non.
Pour les équipes qui se demandent si leur produit d'IA nécessite ce type de changement d'architecture, la question est simple : la conversation est-elle le produit ? Si la réponse est oui, la couche de connexion n'est pas un détail technique. C'est l'architecture du produit.